

Die Kosten für eine Antwort auf künstliche Intelligenz können sinken, wenn die Rechnung des Benutzers steigt. Zwischen Abonnement, verarbeitetem Textvolumen, Suchen und Wiederholungen reicht der angezeigte Preis nicht aus, um das Budget zu messen. Die am 10. November 2026 konsultierten offiziellen Raten erlauben es, diese Ausgaben aufzuschlüsseln, ohne eine billige Antwort mit einer ordnungsgemäß abgeschlossenen Arbeit zu verwechseln.
NachramverarbeiterundstromrechnungDie Preisreihe befasst sich mit einem weniger sichtbaren Aufwand: der von Software, die bei jeder Verwendung Berechnung verbraucht. Für ein unabhängiges, ein kleines Unternehmen oder einen Verein ist die praktische Frage, was im Paket enthalten bleibt und was mit der Aktivität variiert.
Von 2022 bis 2024 ein Rückgang bei definierter Performance
LStanford 2025 Index, veröffentlicht am 7. April 2025, bietet einen historischen Maßstab: Die Kosten für die Infragestellung eines Modells, das GPT-3.5 im MMLU-Test erreicht, stiegen von 20 US-Dollar pro Million Chips im November 2022 auf 0,07 US-Dollar im Oktober 2024. Der Schwellenwert ist 64,8% korrekt. Der letzte Punkt ist Gemini-1.5-Flash-8B.
| Zeitraum | Dollar pro Million Chips |
|---|---|
| November 2022 | 20.00 |
| Oktober 2024 | 0,07 |
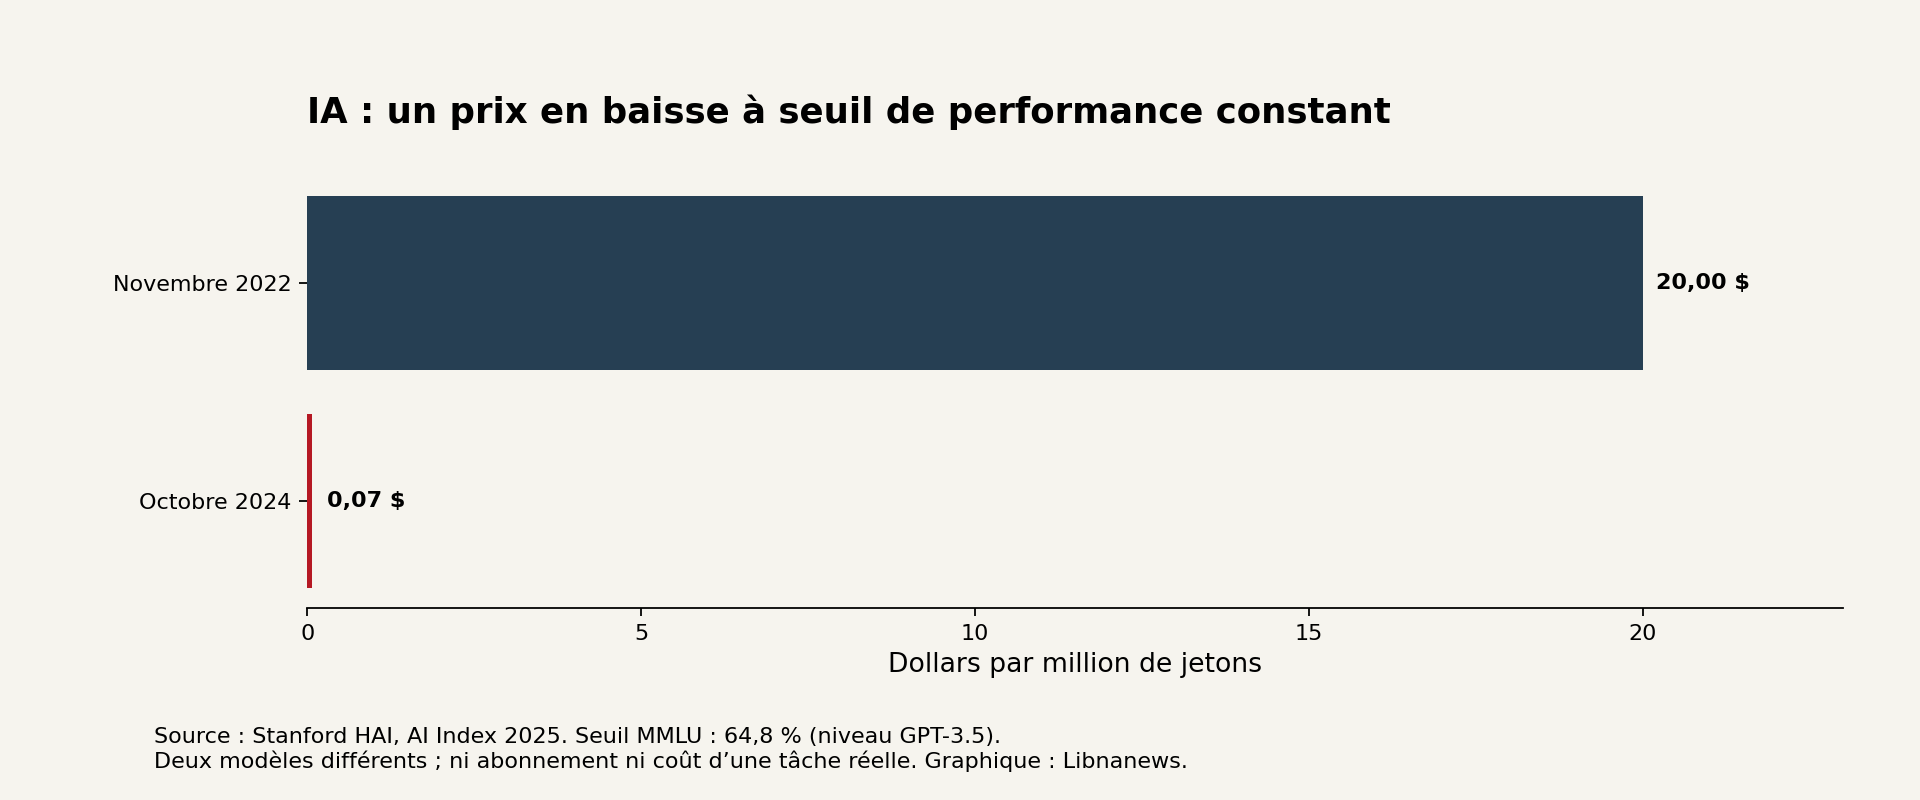
Dies sind zwei Beobachtungen bei einer bestimmten Leistungsschwelle, nicht der Preis des gleichen Produkts für zwei Jahre beibehalten. Sie messen nicht den Preis eines Abonnements oder den Erfolg eines Agenten in einem Unternehmen. Das Verhältnis übersteigt 280, kann aber nicht bis 2026 verlängert werden, ohne die gleiche Methode beizubehalten. Die aktuellen Preise unten sind daher eine zweite Tabelle, getrennt von dieser historischen Serie.
Abonnement und Verbrauch zahlen nicht gleich
In einer Anwendung bietet ein Abonnement Zugriff auf Funktionen und Nutzungskapazität. Eine API ist eine Schnittstelle, die es einer anderen Software ermöglicht, das Modell abzufragen; sein Verbrauch wird im Allgemeinen gezählt. Ein Unternehmen, das die Verarbeitung von Dokumenten automatisiert, muss daher die Bedingungen der API lesen, auch wenn seine Mitarbeiter bereits ein Abonnement haben.
Dieclaude gridveranschaulicht diese Unterscheidung: Pro wird bei $ 20 pro Monat in monatlicher Zahlung oder $ 200 im Voraus für das Jahr bezahlt angezeigt. Max kostet $ 100 pro Monat und Ultra $ 200, ohne anwendbare Steuern. Verwendungsgrenzen bleiben bestehen; Die verbrauchte Menge hängt insbesondere vom Modell, der Länge der Gespräche und den Dateien ab.
Es wäre jedoch falsch zu behaupten, dass beide Rechnungen immer noch völlig getrennt sind. Anthropische Pläne jetztaPI Credits für ausgewählte Abonnenten: 100 Dollar monatlich für Max und 200 für Ultra, unter Aktivierungsbedingungen. Sie verfallen am Ende des Zyklus und beziehen sich nicht. Sie decken nicht Claude Code, Überschreitungen in Claude-Anwendungen oder Partnerplattformen ab. Ihre Höhe stellt daher keinen allgemeinen Abschlag auf alle Benutzungen der Marke dar.
Ein identischer Chipkorb, kein Versprechen des gleichen Ergebnisses
Ein Token ist eine vom Modell verarbeitete Texteinheit, nicht unbedingt ein Wort. Der Eingang versteht, was ihm übertragen wird; die Produktion entspricht seiner fakturierten Produktion. Um Tarife lesbar zu machen, wendet die folgende Tabelle die Basispreise auf einen rein illustrativen Korb an: eine Million nicht eingedeckte Input-Chips und 200.000 abrechenbare Output-Chips, kombiniert auf mehrere kurze Abfragen. Ausgenommen sind Tools, Steuern, Werbekredite, beschleunigte Modi und erhöhte Langzeitbehandlungen.
| Modell | Eintritt pro Million | Produktion pro Million | Kosten für Korb |
|---|---|---|---|
| GPT-6 Luna | 0,10 | 0,50 | 0,20 |
| GPT-6.1 Boden | 2.00 Uhr | 10.00 | 4,00 |
| Claude Sonnet 5,5 | 2.00 Uhr | 10.00 | 4,00 |
| Claude Opus 5,5 | 4,00 | 20.00 | 8.00 Uhr |
| Claude Fable 5.2 | 8.00 Uhr | 40.00 | 16.00 Uhr |
Beträge aus GitternOpenAI, Standardmodus und kurzer Kontext, undAnthropische BasiszinssätzeDie Berechnung ist Input + 0,2 × Output. Zwei identische Preise bedeuten nicht zwei austauschbare Modelle. Das gleiche Dokument kann je nach Modell auch eine unterschiedliche Anzahl von Chips erzeugen. Diese Simulation vergleicht geladene Einheiten; sie klassifiziert nicht die Genauigkeit, Geschwindigkeit oder Kosten einer tatsächlich abgeschlossenen Datei.
Warum lange Antworten mehr wiegen
Im $ 4-Korb kosten Einträge $ 2 und Exits $ 2. Dennoch gibt es fünfmal weniger Chips. Bei diesen Geschwindigkeiten ändert die Notwendigkeit einer längeren Produktion schnell die Kosten. Wenn die Ausgabe von 200.000 auf 400.000 Münzen mit dem gleichen Eintrag steigt, erreicht die Gesamtsumme $ 6, eine Steigerung von 50%. Dies ist eine Szenarioberechnung, keine beobachtete Rechnung.
Suchen können hinzugefügt werden. Insbesondere zeigt das OpenAI-Raster 10 US-Dollar pro 1.000 Standard-Web-Suchanrufe sowie die Abrechnung der an das Modell übertragenen Suchinhalte an. Tausend Suchanfragen werden daher nicht mit tausend einfachen Textantworten verwechselt. Ein Tool, das mehrere Seiten überprüft, neu formuliert und wiederholt, kann Verbrauchsstationen vervielfachen, bevor es einige Absätze liefert.
Die Wiederverwendung eines Dokuments kann die Neuabrechnung reduzieren
Diecache-anweisungen und dokumentevermeiden Sie es, bestimmte bereits behandelte Elemente neu zu berechnen. Es handelt sich um einen gemeinsamen Teil am Anfang des Antrags, der identisch bleiben muss. Die Aufrechterhaltung eines Gesprächs allein garantiert nicht, dass diese Reduzierung gilt.
Für GPT-6.1 Sol, die Rate für das Lesen des Cache ist $ 0,10 pro Million Chips, verglichen mit $ 2 für einen gewöhnlichen Eintrag. Aber das erste Schreiben im Cache hat auch einen Preis: 2,50 $ mit der Standardspeicherzeit von dreißig Minuten. Der Vergleich von nur 0,10 bis 2 US-Dollar würde diese ersten Kosten eliminieren.
Vereinfachtes Beispiel: Derselbe 100.000-Token-Teil, der vollständig wiederverwendbar ist, kostet 0,25 US-Dollar für das Schreiben und 0,09 US-Dollar für neun Lesungen. Die Gesamtsumme beträgt 0,34 US-Dollar, verglichen mit 2 US-Dollar für 10 reguläre Gehälter. Diese Berechnung schließt Outputs und neue hinzugefügte Informationen aus; sie geht von neun erfolgreichen Wiederverwendungen vor dem Ablauf aus. Er beschreibt nicht den Preis eines ganzen Gesprächs.
Warten kann weniger kosten
Geschwindigkeit ist eine weitere wirtschaftliche Wahl. LBatch von OpenAI APIbietet eine 50% reduzierung von synchronen anrufen mit einem 24-stunden-verarbeitungsfenster. Der Lieferant ist insbesondere für die Klassifizierung großer Sets und Auswertungen verantwortlich.
Für ein Unternehmen, das seine Dokumente nachts einreicht, kann dieser Zeitraum akzeptabel sein. Für einen Dienst, der sofort auf einen Kunden reagiert, ändert er den erbrachten Dienst. Der niedrigere Betrag zahlt daher eine weitere Lieferbeschränkung. Alle angekündigten Reduktionen sollten nicht mechanisch addiert werden, ohne zu überprüfen, ob das gewählte Modell und der gewählte Modus dies zulassen.
Der richtige Nenner: die Aufgabe richtig erledigt
In seineroptimierungsführungAnthropic empfiehlt, die Kosten pro abgeschlossener Aufgabe und nicht den einzigen Token-Preis zu vergleichen. Ein mehr Einheitspreismodell kann Wiederholungen reduzieren; Umgekehrt kann die Verwendung des teuersten für jedes elementare Ranking das Budget unnötig erhöhen. Die vom Hersteller präsentierten Ergebnisse bleiben einzigartig für seine Tests und ersetzen keinen Test auf den Dokumenten des Kunden.
Die konkrete Methode besteht darin, eine stabile Stichprobe zu nehmen, zu definieren, was eine akzeptable Antwort ist, und dann Verbrauch, Fehler und Korrekturen zu identifizieren. Schwierige Dateien müssen in dieser Stichprobe verbleiben. Das Entfernen würde die durchschnittlichen Kosten künstlich verbessern und genau die Fälle maskieren, die die meiste Arbeit erfordern.
OpenAI identifiziert drei Hebel in seinemkostensenkungsleitfaden: Begrenzen Sie die Anzahl der Abfragen, reduzieren Sie das Textvolumen und wählen Sie eine kleinere Vorlage, wenn die Genauigkeit ausreicht. Für den Leser bedeutet dies einfache Fragen: Müssen Sie die komplette Datei zurückgeben, zehn Seiten anstelle einer Synthese erhalten oder die gesamte Aufgabe für eine einzige Korrektur neu starten?
Das zu befolgende Budget umfasst mehrere Linien: mögliche Pauschalbeträge, Nettoverbrauch nach tatsächlich nutzbaren Krediten, Werkzeuge und dann menschliche Auditzeit. Es gibt keine öffentliche Skala, um einen universellen Preis für diese letzte Zeile zuzuteilen. Genau deshalb erlaubt es sich ein Preis pro Million Token, auch wenn er sehr niedrig ist, nicht, eine Wirtschaft auf Endarbeit zu versprechen.

Kommentare